引言:策略選擇,影響遠比你想像的深遠! #
想像一下,你在訓練機器人時,滑鼠輕輕一點,選擇了「訓練策略」——看起來只是選個演算法,其實這一點,決定了示範次數、訓練時間,甚至三個月後這套系統會跑在哪台硬體上!今天就讓我們一起揭開「策略選擇」的神秘面紗,讓你在點下去之前,已經掌握全局!
背景與技術概述:任務變化,策略大不同 #
在現今自動化產線,AI機器人正逐步取代傳統人工操作,但面對不同任務,該怎麼選擇最適合的訓練策略?答案很簡單——看你的任務有沒有「變化」!
兩大主角登場: #
- ACT:適合動作固定、環境穩定的任務。像是產線上工件總是擺在同一格、光線不變、機械臂每次走同一條路。ACT就像新進作業員,專注記憶動作、穩定執行。
- GR00T N1.5:適合物件位置或外觀會變的任務。例如料件每次位置都不同、零件尺寸多變、現場光線有時昏暗有時明亮。GR00T N1.5是NVIDIA預訓練的大型機器人模型,像資深師傅,能理解指令、判斷現場狀況、靈活調整動作。
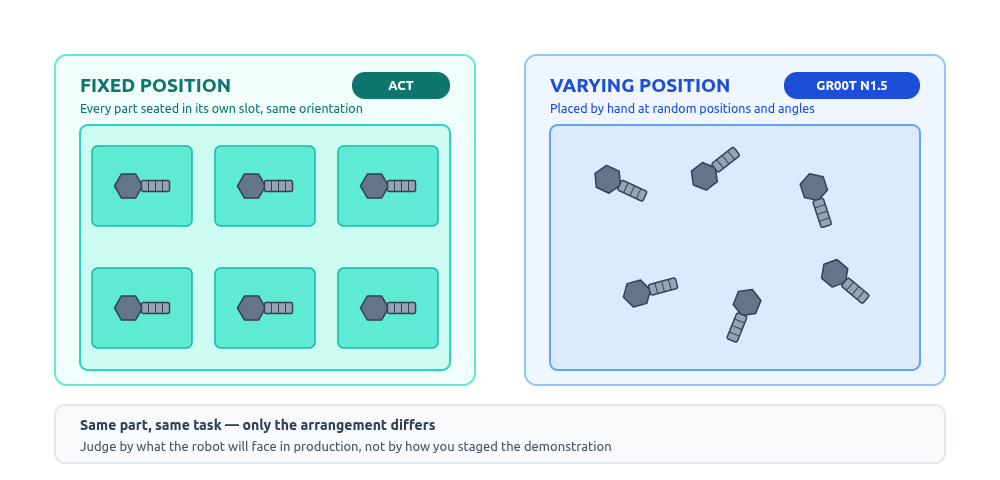
小提醒: 判斷要選哪一種,請以「實際運作時」的變化為主,不是錄製時的狀況!如果上線後料件都是隨手放,請直接選GR00T,並在示範時錄入各種位置變化。
實作過程與重點發現:示範次數、品質門檻與操作細節 #
錄示範,是訓練AI機器人最「現實」的一步——這就是人力成本!每一次你親手帶著Leader Arm走完整個任務,都是寶貴的資料。
| ACT | GR00T N1.5 | |
|---|---|---|
| 學習方式 | 從零開始學動作 | 基礎能力上微調 |
| 示範次數需求 | 數十次才能穩定 | 少量示範就能上線 |
| 錄製工時 | 高 | 低 |
| 示範一致性要求 | 每次要很一致 | 容許些微差異 |
如果你選ACT,請準備好「重複數十次」的耐心。選GR00T就輕鬆多了,示範幾次即可。不過注意,示範少不代表可以隨便錄!每一次都很重要,任何動作猶豫都可能影響整體品質。如果人力極度有限,還能用模擬環境自動生成訓練資料——這部分我們未來會深入介紹。
成果與應用:部署硬體,決定策略!突破傳統邊界 #
這一節,絕對是「最容易被忽略、最容易後悔」的地方!
Advantech的Physical AI平台提供兩條部署路徑——但每條路徑只吃一種策略:
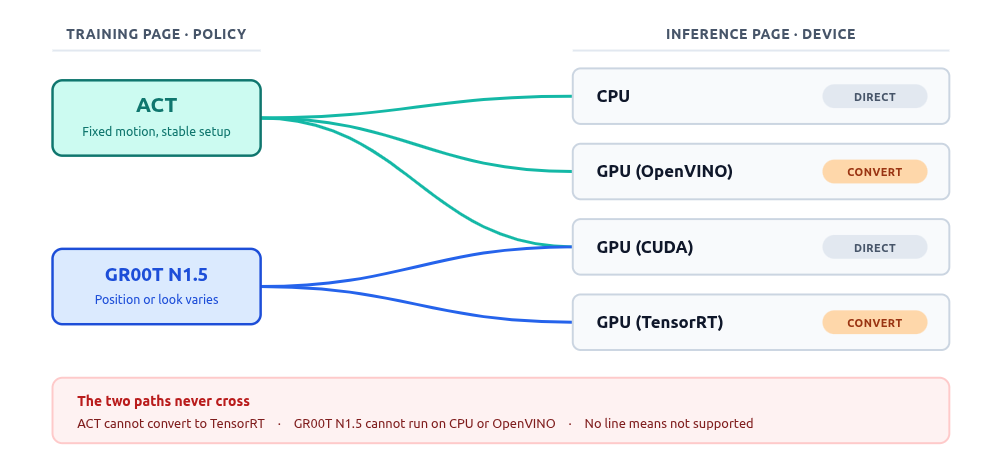
- Intel平台邊緣裝置(無獨立顯示卡、成本與功耗敏感)→ OpenVINO → 必須選ACT
- NVIDIA Jetson AGX Thor等邊緣平台(節拍嚴苛、多路影像)→ TensorRT → 必須選GR00T N1.5
- 配有NVIDIA顯示卡的工作站驗證→ GPU (CUDA) → 兩種策略都能直接載入
換句話說,策略選擇就像「選引擎規格」,決定了未來能加哪種油。訓練頁面的硬體選項與推論頁不同,請記得:GPU (TensorRT)只在推論頁出現,別誤以為GR00T不能用——訓練與部署本來就分階段!
決策速查表:30秒選出最適合你的策略 #
| 你的情境 | 建議策略 |
|---|---|
| 工件位置固定、動作重複 | ACT |
| 工件位置或外觀常變 | GR00T N1.5 |
| 現場只能用Intel邊緣裝置、不裝顯示卡 | ACT(唯一能走OpenVINO) |
| 現場是NVIDIA Jetson平台、節拍要求高 | GR00T N1.5 |
| 人力充足,可錄數十次示範 | 依前述決定 |
| 只能錄少量示範 | GR00T N1.5 |
| 只想先看效果、評估階段 | ACT(訓練快、硬體門檻低) |
| 想比較兩者表現 | 兩個都訓練一次 |
小技巧: 同一批示範資料,兩種策略都訓練一次!資料集是標準格式,只要換策略、換資料夾名稱再跑一次。這樣不用猜,直接用結果決定最適合你的方案。唯一的代價是訓練時間與磁碟空間——如果不是瓶頸,建議都跑!
結論與未來展望:策略選擇,就是硬體選擇!持續突破,智慧自動化更簡單 #
ACT與GR00T N1.5不是「入門與進階」的關係,而是面對不同不確定性、不同硬體需求的解決方案。你的任務變化程度、現場硬體限制,直接決定了策略選擇。如果硬體規格早已定案(如只能放Intel邊緣裝置),那策略早就被決定——早知道,勝過訓練完才發現無法部署!
如果還沒決定,建議先用ACT完整走一次流程——訓練快、硬體門檻低,能讓你對任務需求有更直觀的判斷。
Advantech在Physical AI領域持續研發、積極創新,讓教機器人變得簡單,讓自動化更容易上手。下一步,就是錄示範資料——而錄之前,該怎麼決定相機擺放位置?敬請期待我們的下一篇專業解析!
Physical AI - 讓教機器人變得簡單,讓自動化變得可能。